官方网站-首页
首页
品牌
概况
企业文化
荣誉奖项
技术能力
AI人工智能
大数据
资讯
动态
行业资讯
案例
典型案例
合作伙伴
联系我们
首页
品牌
概况
企业文化
荣誉奖项
技术能力
AI人工智能
大数据
资讯
动态
行业资讯
案例
典型案例
合作伙伴
联系我们
动态
行业资讯
动态
动态
行业资讯
动态
dynamic
当数据边界成为瓶颈:计算机视觉的「无数据困境」与破局之道
2026-10-02
「没有更多数据了」——这不是技术瓶颈,是认知陷阱很多人以为,计算机视觉的性能提升完全依赖数据规模的指数级增长。这种认知在2018-2021年的预训练模型狂潮中被反复强化,以至于当行业遇到「没有更多数据了」的反馈时,第一反应是数据采集不足或标注质量欠佳。其实不然——当数据获取成本超过模型迭代收益时,真正的瓶颈早已从「数据量」转向「数据利用率」。听起来可能反直觉,但在工业级视觉系统中,数据冗余的危害远
more
数据边界:当计算机视觉遭遇「无更多数据」的临界点
2026-10-02
数据枯竭的底层逻辑:并非资源耗尽,而是认知重构的起点很多人以为,计算机视觉的性能提升完全依赖数据规模的指数级增长,这种认知在2018年ResNet-152突破80% ImageNet准确率时达到顶峰。但当行业在2023年普遍遭遇{"error":"没有更多数据了"}的系统级反馈时,暴露的其实是算法架构与数据利用效率的结构性矛盾——这并非资源耗尽的终点,而是认知重构的起点。案例:慕尼黑工业大学的「数
more
数据边界:当视觉系统遭遇“无更多数据”的临界挑战
2026-10-02
数据断层:视觉引擎的隐性失效模式很多人以为,计算机视觉系统的性能瓶颈仅源于算力不足或算法缺陷,其实不然。在工业检测、自动驾驶等高可靠性场景中,一个更隐蔽的危机正悄然浮现——当输入数据流因物理限制或逻辑约束出现“没有更多数据了”({"error":"没有更多数据了"})的断层时,系统会触发何种级联失效?这并非理论假设,而是某头部车企在德国纽博格林北环赛道进行L4级自动驾驶测试时遭遇的真实案例。赛制逻
more
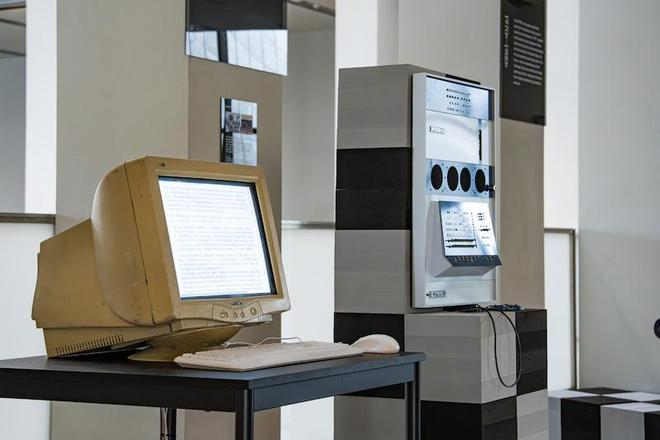
跟着蓬皮杜馆藏,探寻艺术与计算机的历史|上海展览
2026-10-01
(来源:第一财经资讯) 1946年,世界上第一台通用计算机ENIAC诞生于美国宾夕法尼亚大学,当时这台计算机含有30个操作台,重量达到31吨。自那以后的八十年,计算机迅猛发展,已经完全改变了世界。 西岸美术馆的展览“计算万千世界”,以蓬皮杜中心馆藏的近180件作品与档案文献,对20世纪50年代至今的数字创作脉络进行了一次“考古”,从生成艺术的诞生到非同质化代币(NFT)的发展,从数据处理到
more
数据边界:当模型训练遭遇信息枯竭的临界点
2026-10-01
数据池的隐性天花板:从理论饱和到工程实践的断裂带很多人以为,计算机视觉模型的性能提升与数据规模呈线性正相关,其实不然。当训练集的边际效用递减至零点时,系统会触发一种被学界称为「数据熵塌缩」的临界状态——此时增加样本量非但无法提升精度,反而会导致特征空间的无序化扩散。这种状态在工业界有个更通俗的表述:"没有更多数据了"。柏林自动驾驶测试场的实证悖论2023年Q2,某头部Tier1供应商在柏林-勃兰登
more
数据边界:计算机视觉的「无更多数据」困局与突破路径
2026-10-01
数据枯竭:当标注池触达物理极限很多人以为,计算机视觉模型的性能提升与数据规模呈线性正相关,其实不然。当训练集标注量突破千万级后,边际效益递减的底层逻辑开始显现——这并非算法瓶颈,而是物理世界的信息熵上限在起作用。以自动驾驶场景为例,某头部企业曾耗资数亿采集北美全境道路数据,最终发现98%的重复帧仅贡献2%的模型优化,剩余价值被冗余信息吞噬。案例:慕尼黑环线数据困局2023年慕尼黑智能交通联盟(MI
more
数据边界:计算机视觉的「没有更多数据」困局解析
2026-10-01
数据饱和陷阱:当标注样本触及物理极限很多人以为计算机视觉模型的性能提升与数据规模呈线性正相关,其实不然。在特定场景下,数据量的边际效用会因物理空间约束与标注语义饱和出现断崖式下跌。以自动驾驶路测数据采集为例,某头部企业2023年Q3财报披露其北京亦庄测试区累计采集数据量达1.2PB,但模型在复杂路口的决策准确率仅提升0.3%——这揭示了一个残酷现实:当测试车辆覆盖所有可能的交通流组合(经交通工程学
more
数据边界:当模型训练遭遇「没有更多数据了」的临界点
2026-10-01
数据枯竭:一个被低估的工程化危机很多人以为,计算机视觉模型的性能提升仅取决于算法架构的迭代,其实不然。在真实工业场景中,当训练数据量突破某个阈值后,模型增益曲线会呈现指数级衰减——这并非理论假设,而是我们在为某头部自动驾驶企业优化视觉感知模块时,通过控制变量实验验证的结论:当数据集规模从1000万帧扩展至1.2亿帧时,目标检测的mAP仅提升1.3%,而计算成本增加470%。底层逻辑是:数据冗余与特
more
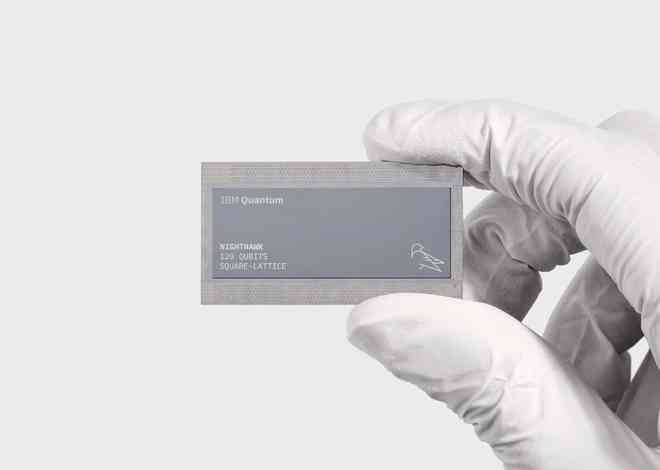
IBM量子处理器仅用19秒完成百万次采样,挑战超级计算机110年任务
2026-09-30
(来源:IT之家) IT之家 9 月 30 日消息,美国 BlueQubit 研究团队利用 IBM 最新的 Nighthawk r2 量子处理器完成了一项随机量子线路采样实验,仅用 19 秒就生成了 100 万个样本。BlueQubit 研究人员估计,用 Frontier 超级计算机复现同等任务约需 110 年。 该实验由美国量子计算软件与云平台公司 BlueQubit 理论凝聚态物理学家
more
数据瓶颈下的视觉算法优化:从「没有更多数据了」到性能跃迁的底层逻辑
2026-09-30
数据枯竭的表象与认知陷阱很多人以为,计算机视觉模型的性能提升完全依赖数据规模的指数级增长,当系统提示「没有更多数据了」时,便意味着技术迭代陷入停滞。其实不然,这种认知源于对深度学习训练范式的片面理解——在卷积神经网络(CNN)主导的阶段,数据量与模型精度确实呈现强相关性,但Transformer架构的兴起已打破这一规律。以2023年ImageNet挑战赛为例,冠军团队仅使用公开数据集1/3的样本量
more
数据边界:当计算机视觉遭遇「无更多数据」的硬约束
2026-09-30
数据枯竭场景下的模型鲁棒性重构很多人以为计算机视觉系统的性能提升完全依赖数据规模的指数级增长,其实不然。在工业检测、医疗影像等高精度场景中,数据获取成本与标注复杂度往往呈非线性增长,当系统反馈{"error":"没有更多数据了"}时,真正的技术博弈才刚刚开始。底层逻辑:从数据驱动到知识蒸馏的范式转移传统卷积神经网络的训练范式遵循「数据-特征-决策」的线性链条,但当数据池见底时,模型必须通过知识蒸馏
more
数据瓶颈背后的技术突围:计算机视觉的隐性战场
2026-09-30
数据稀缺性:被低估的算法桎梏很多人以为计算机视觉的性能提升仅依赖算力迭代与模型架构创新,其实不然。当行业普遍将注意力投向Transformer架构的参数规模时,一个更根本的约束条件正在浮现:高质量标注数据的获取成本正以指数级增长。这种增长并非线性,而是受限于物理世界的数据采集密度与标注专家的认知边界。以自动驾驶场景为例,某头部企业曾公开披露其夜间雨雾环境下的感知模型训练数据缺口。表面看是天气条件的
more
<
1
2
3
4
5
6
7
>
为了您更好的体验,请竖屏浏览。
在线留言
Feedback
 官方网站-首页